资源介绍
视频数量:28个
总时长:1小时47分
课程介绍:
Fabric数据平台监控优化与故障排查实战
数据工程师最怕什么?半夜三点被电话叫醒,告诉你报表全是空的。或者跑了八个小时的数据流水线,最后一个环节报错,前功尽弃。又或者老板问你为什么这个月的云账单比上个月翻了一番,你张了张嘴,愣是答不上来。这些场景,做过数据项目的人都懂。Microsoft Fabric把数据工程、湖仓、仓库、实时流、Notebook全部塞进了同一个平台,功能确实强大了,但出了问题和遇到性能瓶颈的时候也比以前更难排查。这门课就是来解决这些头疼事儿的,讲师Thomas LeBlanc是Power BI社区里知名的数据建模专家,他会把监控调优的整套思路掰开揉碎讲给你听。
一、监控Fabric平台各项组件
先说监控。Fabric平台里的东西不少,Lakehouse、Warehouse、Eventhouse、Semantic Model、Pipeline、Notebook、Dataflow,每一个都有自己的运行状态和日志。课程第一部分就带你熟悉整个监控体系。怎么用Monitor Hub查看各项工件(Artifact)的运行情况,哪个任务成功了,哪个失败了,运行了多久,消耗了多少资源,这些信息在哪里能找到。
光听不练假把式。课程里有专门的操作演示,手把手带你打开Monitor Hub看一个真实任务的监控面板,告诉你每一列数据代表什么、怎么快速定位异常。日志(Logging)部分则更深入一层,讲的是怎么开启诊断日志、配置Log Analytics工作区,把运行记录持久化下来,这样出了问题可以追溯,不至于两眼一抹黑。最后还会演示怎么监控Semantic Model(语义模型)的刷新状态和数据集健康度,很多团队只盯着数据管道跑没跑通,忽略了数据集刷新失败导致的报表空白,这部分内容正好补上这个盲区。
二、识别与解决批处理中的常见故障
批处理是日常数据工作的主力,但也最容易出问题。Pipeline、Dataflow和Notebook这三大工具的常见故障,是课程第二部分的重点。
Pipeline报错是家常便饭。课程先讲错误的分类和排查思路:活动失败、超时、权限不足、连接断开,每种情况对应不同的处理方式。演示环节会用条件分支(Conditional Pipeline Flow)构建一个容错性更强的流程,比如某个活动失败后自动发邮件通知,或者跳过非关键步骤继续往下走。还有专门的演示展示如何配置邮件失败通知,让你不再需要手动盯着屏幕看任务跑没跑完。
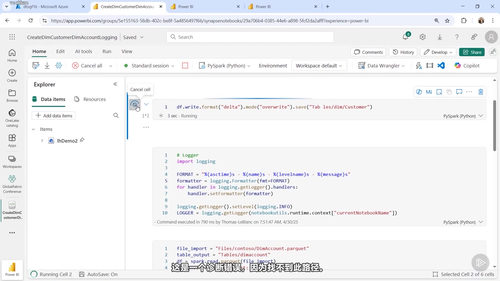
Dataflow的数据流问题也不少。表名冲突、刷新策略冲突、数据源连接中断,每一种都有对应的解决套路。Notebook部分则讲最佳实践,变量怎么管理、单元格执行顺序如何控制、Spark会话怎么复用。演示环节还会模拟几个常见的Notebook错误,比如依赖包缺失、内存不够、集群启动失败,带着你一步步排查。
三、排查Eventhouse与Warehouse的查询问题
实时流处理这块,Fabric里的Eventhouse(事件屋)和Eventstream(事件流)是两个核心组件。课程第三部分专门讲这两个东西的监控与排错。
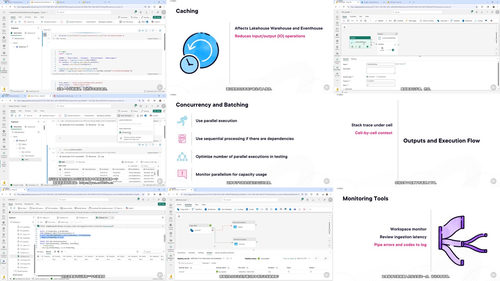
Eventhouse的监控演示会教你怎么看KQL查询的性能指标、数据库的摄入(Ingestion)状态、缓存命中率。Eventstream的错误则更隐蔽,上游schema变了,下游没跟上,数据就丢了。演示会用一个真实场景还原事件流schema变更的故障,教你怎么配置schema漂移检测,怎么在数据断流时第一时间收到告警。
Warehouse查询性能问题更是高频痛点。课程会分析常见的查询瓶颈,统计信息过期导致执行计划走错、索引缺失全表扫描、约束冲突插入失败。演示环节会用真实SQL查询做对比,展示添加合适约束和更新统计信息前后的性能差异。
四、性能优化的核心策略
最后一部分是重头戏,也是整个课程信息密度最高的部分。讲师从性能优化的整体思路讲起:为什么要优化?为了降延迟、降计算成本、满足SLA,这三个目标贯穿始终。Fabric里的不同引擎有不同的优化侧重:Lakehouse底层全是Delta表,Warehouse有视图和存储过程,Notebook跑的是Spark集群,引擎特性不同,优化手法也各不相同。
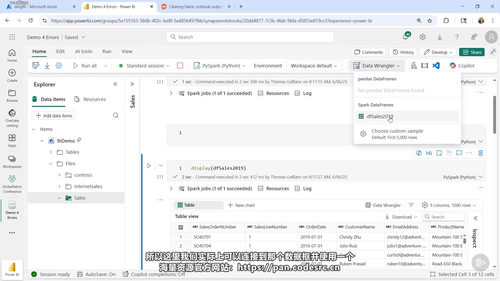
Lakehouse优化部分会讲表结构的设计原则,避免列数过多或底层Parquet文件过大的"宽表",通过V-Order压缩减少存储占用,使用OPTIMIZE命令合并小文件,用Z-ORDER对常用查询列做聚簇。演示环节会把一个真实数据文件读进来,通过关闭自动合并、运行OPTIMIZE、应用V-Order等一系列操作,让查询速度产生肉眼可见的变化。另外也会讲到快捷方式(Shortcut)和镜像(Mirroring)这两种省存储、省搬运的好用的方案,还有分区策略的选择,建议按日期或区域拆大型数据表。
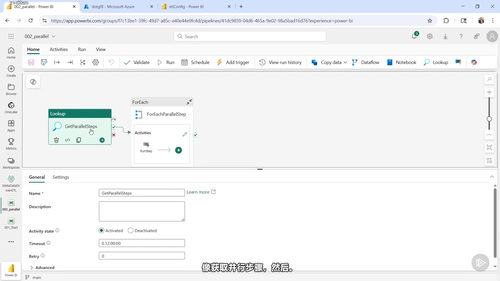
Pipeline优化则讲怎么把大管道拆成多个并行执行的小管道,缩短整体耗时。演示会配置并行管道,展示并发执行带来的时间收益。Warehouse部分讲查询调优工具和步骤,怎么用查询分析器看执行计划,怎么更新统计信息让优化器做出更好选择,怎么识别和解决阻塞问题。最后还会讲到Fabric中各种常见报错信息的解读,以及怎么根据工作负载类型配置合适的计算环境规模,小查询用小集群,大批量处理用大集群,中间档按需弹性伸缩。
五、适合谁学,能带走什么
这门课适合正在准备DP-700认证考试的数据工程师,也适合已经日常使用Fabric但苦于性能问题和故障排查的实战派。如果你正在负责一个Fabric项目,数据管道越来越多却越来越慢,想找系统化的排查和优化方法,这门课能帮你少走很多弯路。
学完整个课程,你会掌握三样东西。第一,能用Monitor Hub和诊断日志建立完整的监控体系,做到问题早发现早处理。第二,面对Pipeline、Dataflow、Notebook、Eventhouse、Warehouse的常见故障,能快速定位根因并修复。第三,能系统性地对Lakehouse、Pipeline、Warehouse做性能优化,让查询跑得更快、云账单降下来。
数据工程的活儿,三分建七分养。建容易,养才是真功夫。这门课把"养"的功夫讲透了。