资源介绍
视频数量:40个
总时长:3小时44分
课程介绍:
大语言模型强化学习微调:DeepSeek方法与GRPO技术
DeepSeek R1横空出世的时候,很多人都在问同一个问题:它到底是怎么训练出来的?为什么一个开源模型能做到这种程度?答案就藏在GRPO——组相对策略优化这个方法里。这门课做的事情,就是把DeepSeek R1背后那套强化学习微调技术掰开揉碎,从最基础的准备工作一直讲到完整的GRPO训练流程,让你真正理解每一步在做什么、为什么这么做。
课程总共五个部分,40个视频,时长三个半小时出头。讲师Chaatai目前在英国南安普顿大学读人工智能硕士,对大语言模型有比较深入的研究。整门课的风格偏实战,每个知识点都配有对应的Notebook代码,跟着做就能跑通。
一、基础准备:搭建微调环境
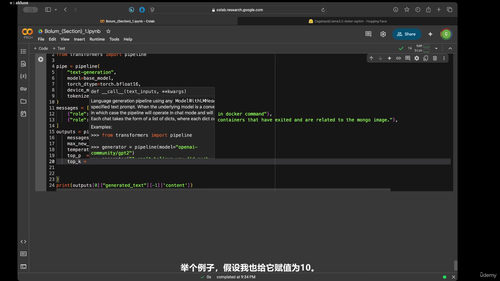
这个部分解决的是"工欲善其事"的问题。要在消费级显卡上微调大模型,第一道坎就是显存。课程讲清楚量化是什么、它如何影响模型的体积和参数表现,让你理解为什么4-bit量化能让一个7B模型塞进普通显卡里。之后从注册Hugging Face账号、获取Token开始,到创建Colab Notebook、熟悉Transformers和PEFT等常用库的用法,一步一步把环境搭起来。Base模型和Instruct模型的区别也会专门讲到——很多人拿到模型直接就用,根本没想过为什么有的模型只会续写、有的能对话。这个区别搞不清楚,后面的微调就无从谈起。
二、监督微调:LoRA与数据准备
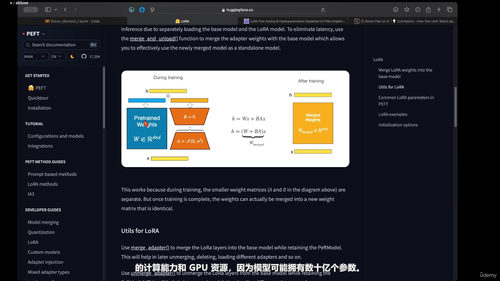
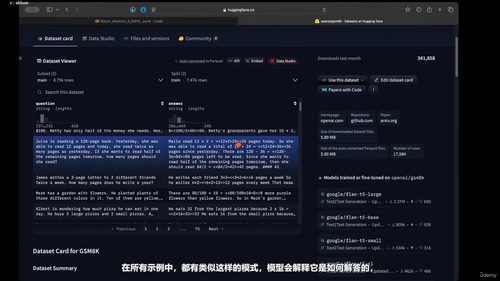
环境准备好之后,进入监督微调(SFT)的实操环节。课程带你看怎么下载和检查数据集,怎么用聊天模板(Chat Template)把数据整理成模型能吃的格式。Tokenizer的apply_chat_template函数到底做了什么、数据为什么必须是字典和列表的结构,这些细节讲得很清楚。Data Collator是很多人忽略的环节,但它直接决定了训练时数据的处理方式,课程用一个实际例子演示它的工作原理。LoRA部分覆盖了为什么要用LoRA、它的矩阵是怎么嵌进模型里的、训练完之后怎么把LoRA矩阵合并回主模型。训练参数怎么设、Trainer怎么配、超参数对输出有什么影响,这些都有专门讲解。最后演示怎么把训练好的模型上传到Hugging Face并实际调用。
三、Tokenizer定制与DPO偏好优化
想让模型理解一些新概念或专业术语,光靠提示词不够,得往Tokenizer里加新词。课程演示怎么下载模型和Tokenizer、怎么添加自定义Token,再用这些新Token构建模板整合进数据集。这个能力在做垂直领域微调时特别管用。DPO(直接偏好优化)是进入强化学习之前的过渡技术。课程从DPO的数据格式讲起,解释偏好数据为什么是"一个提示词配两个回答、一个好的一个差的"这种结构,DPO的数据Collator又是怎么做padding的。然后同样走一遍LoRA配置、训练参数设定、模型合并的完整流程。
四、GRPO核心:DeepSeek R1的训练秘诀
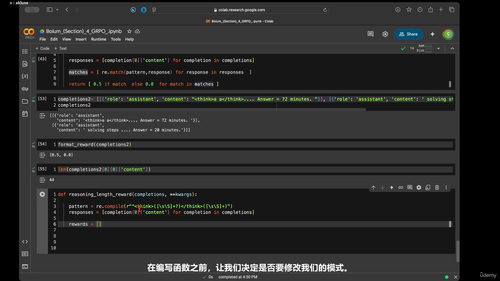
这是整门课最核心的部分,占的篇幅最大。首先解释什么是推理模型(Reasoning Model),它和普通聊天模型有什么区别、内部工作机制是怎样的。GRPO作为DeepSeek R1的关键训练方法,它的原理和应用方式被详细拆解。工具层面介绍Unsloth和VLLM——前者大幅加速训练并降低显存占用,后者用于高效推理部署。数据处理涉及正则表达式和分组操作来提取特定字段,以及数据以什么格式送进奖励函数这个关键问题。GRPO的灵魂在于奖励函数的设计,课程一口气讲了四个不同侧重点的奖励函数,从格式合规性到内容正确性,每个函数的设计逻辑和实现细节都给出具体方案。训练参数用GRPOConfig配置,Trainer对象的用法和训练过程监控也会演示到位,最后用结果表格展示奖励值变化和样本输出。
五、补充实战:SFT加GRPO完整流程
最后的Bonus部分提供了一份新的Notebook,把监督微调和GRPO训练串成一条完整的流水线,适合想看完整项目结构的同学参考。
这门课适合已经了解Transformer基础、跑过Hugging Face模型、想进一步深入大模型微调特别是强化学习方向的人。不需要你已经是强化学习的专家,但基本的Python和PyTorch使用经验会让学习过程顺畅很多。跟下来之后,你不仅能理解DeepSeek R1的训练逻辑,还能自己动手复现类似的强化学习微调流程。