资源介绍
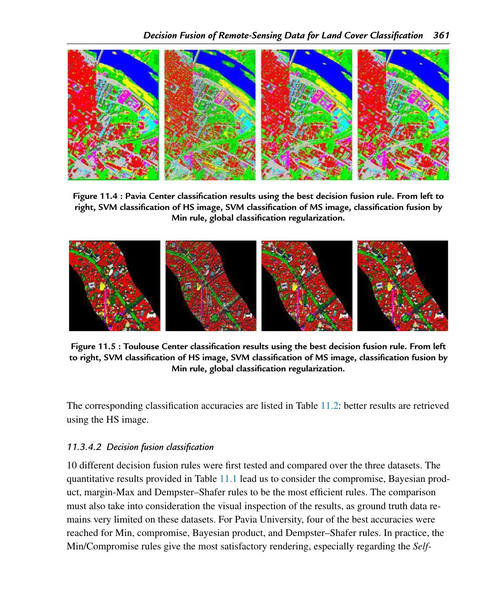
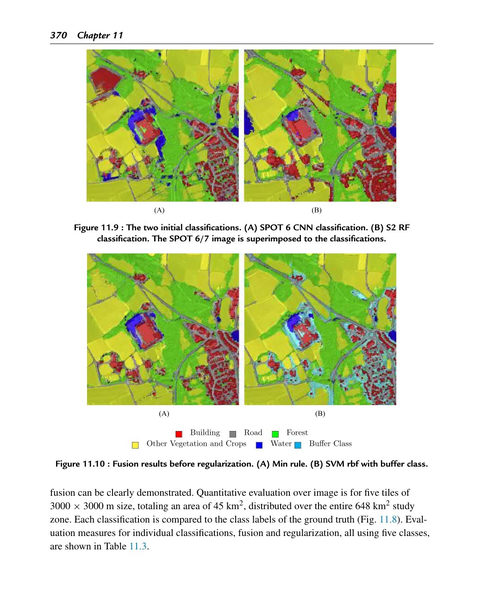
这是一本关于计算机视觉领域多模态场景理解的专业学术著作,由三位在图像处理和计算机视觉领域颇有建树的学者共同主编。Michael Ying Yang和Bodo Rosenhahn来自德国汉诺威莱布尼茨大学信息处理研究所,Vittorio Murino则是意大利技术研究院的模式分析与计算机视觉领域的负责人。这本书2019年由学术出版社(Elsevier旗下品牌)出版,面向的读者群体非常明确——从事计算机视觉、多传感器融合和深度学习研究的研究人员、研究生以及工程师。全书共分为十二章,几乎涵盖了多模态场景理解这一方向的所有重要议题。第一章作为引言为读者勾勒出整个领域的框架,第二章由日本国立产业技术综合研究所的Asako Kanezaki等人撰写了多模态数据融合的深度学习方法,这是近年来极为活跃的研究方向。第三章到第五章分别讨论了RGB与深度数据融合的语义分割、少量训练数据下的目标检测以及行人检测的多模态融合架构,这些内容对自动驾驶和智能监控应用有直接的参考价值。第六章介绍了一种基于生成对抗网络的多光谱行人重识别方法,将可见光图像转换为热红外图像,解决了夜间或恶劣光照条件下的识别难题。第七章到第九章转向了定位与检索问题,包括视觉惯性里程计的综述、嵌入式系统上的多模态定位方法以及从网页数据进行自监督学习的多模态检索。后几章的内容更加丰富多元,第十章讨论了利用多传感器影像进行三维城市场景重建与解译,第十一章聚焦于遥感数据决策融合在土地覆盖分类中的应用,第十二章则探讨了RGB-D视觉中通过"幻觉"缺失模态进行跨模态学习的创新思路。读完目录就能感受到,这本书的一大特点是实践性很强,每一章虽然都有理论阐述,但都紧扣具体的应用场景——从自动驾驶汽车的环境感知到无人机城市建模,从遥感图像分析到嵌入式设备的视觉定位,几乎涵盖了多模态视觉技术的主要落地领域。书中的作者团队也相当国际化,既有来自德国、法国、意大利等欧洲国家的研究者,也有来自中国浙江大学、日本产业技术综合研究所以及俄罗斯莫斯科物理技术学院的学者,这种全球化的合作也反映了计算机视觉研究本身的国际化属性。对于刚刚进入这个领域的研究生来说,这本书提供了一个很好的概览,可以快速了解多模态融合技术的整体图谱和最新进展;对于已经在某个细分方向有所积累的研究者,书中的其他章节也能帮助拓宽视野,看看同行们在其他应用场景中是如何处理类似问题的。需要注意的是,这是一本偏重技术和方法的学术著作,内容涉及大量的数学推导、神经网络架构设计和实验对比分析,对读者的数学基础和机器学习背景有一定要求,比较适合计算机、电子信息、自动化以及遥感科学等相关专业的高年级本科生、研究生和科研人员阅读。