资源介绍
视频数量:153个
总时长:13小时22分
课程介绍:
数据工程实战训练营
你有没有想过,打开外卖软件看推荐菜品的瞬间、刷到一条精准推送的短视频背后,到底是什么系统在支撑着这一切?答案就是数据工程。
数据工程师就像数字世界的管道工,他们搭建系统把四面八方的原始数据收集起来、清洗干净、转化成可用的格式,再输送给分析师、算法工程师和产品团队。可以说,没有数据工程师搭建的基础设施,再漂亮的商业模型和AI应用都是空中楼阁。这门训练营会带你走完从入门到进阶的完整路径。
一、基础概念与环境搭建:
课程一开始会回答几个根本问题:数据工程师到底是做什么的?需要哪些前置技能?职业发展路径长什么样?对于Python基础薄弱或者对虚拟环境、容器这些概念还不太熟悉的同学,课程专门准备了虚拟环境搭建和Docker入门的补充内容,帮大家把地基打牢。
二、Apache Spark核心技术与实战:
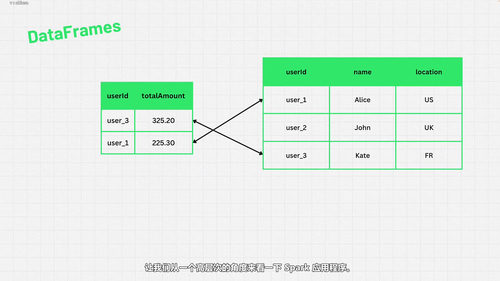
这是训练营的重头戏之一。你会从Spark的底层原理开始学起,理解它为什么比传统的MapReduce快上百倍,关键就在于它把中间结果保存在内存里而不是反复读写磁盘。课程会带你亲手安装Spark,然后用Inside Airbnb的真实数据集写出第一个处理任务。从DataFrame的基本操作开始,你会逐步掌握惰性求值、聚合、关联表、复杂数据类型处理、用户自定义函数这些核心技能。编排节奏很讲究,每讲完一个知识点就安排对应练习,比如基础函数练习和聚合函数练习,让你边学边练。进阶部分还会深入讲解数据Shuffle、数据累加器、Spark作业调优、向集群提交Spark任务这些实战技巧,最后对比Spark多种API(RDD、DataFrame、SQL)的适用场景。
三、数据湖与AWS云上实战:
光在本机跑通Spark还不够,真正的数据工程需要上云。这一模块先解释什么是数据湖、它和传统数据库的区别,然后带你注册AWS账号、配置IAM权限、把数据存到S3上。你会学到数据分区策略、Parquet列式存储格式的优势、如何在EMR Serverless上运行Spark作业。课程还会演示如何搭建数据目录系统,以及如何直接用SQL查询数据湖里的数据。整个过程完全跟着真实操作走,学完之后你就有能力在AWS上从零搭建一个可用的数据平台。
四、Apache Airflow任务编排:
数据管道不是写一个脚本就完事了,需要一套调度系统来管理任务执行顺序、失败重试和依赖关系。Airflow是目前最主流的解决方案。这部分从Airflow的架构讲起,教你定义DAG有向无环图、处理任务错误、设计幂等任务。课程演示如何把Spark任务接入Airflow实现自动化调度,数据接入部分教你从PostgreSQL读取数据,并用真实案例演示平均客户评分的计算。配合数据验证练习和高级Spark练习两个环节,你会真正掌握如何用Airflow串联起完整的数据流水线。
五、机器学习与数据工程的融合:
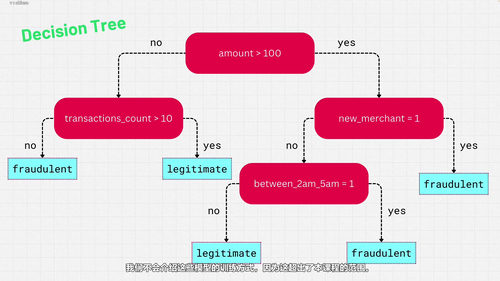
数据工程的终点不是把数据存好,而是让数据产生价值。课程后半段带你进入机器学习的世界。从什么是机器学习开始,你会学到回归算法的原理,用真实数据集训练房价预测模型,掌握模型评估指标、特征工程和模型调优的方法。然后过渡到分类算法,理解如何用历史数据预测贷款申请是否会通过。深度学习部分会快速讲解神经网络的基本概念,以及它和传统机器学习的区别。
六、大语言模型与数据工程结合:
这是训练营里最前沿的部分。你会先回顾NLP在LLM出现之前的发展脉络,理解从词嵌入到Transformer架构的演进,搞清楚BERT、GPT等不同类型大模型的差异。课程会带你使用Hugging Face平台调用开源大模型,在Databricks环境中部署模型。你会学到如何让大模型输出结构化的JSON结果,以及如何把LLM集成到现有的Spark数据处理流程中。这一块内容非常实用,因为越来越多企业开始用LLM做数据清洗、文本分类和信息提取。
七、Apache Kafka实时数据流处理:
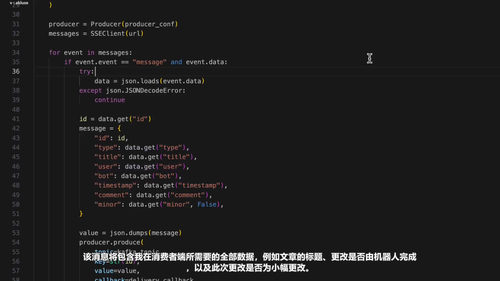
处理完批量数据,下一步就是处理实时数据。Kafka是实时数据传输领域的核心组件。课程从Kafka的基本概念讲起,包括数据分区机制、API使用方式和整体架构。你会亲手搭建Kafka集群,学会往Kafka写数据和从Kafka读数据,理解数据持久性保障机制。还会讲解Kafka与消息队列的区别、数据交付语义、Kafka事务机制、日志压缩、级联存储这些高级特性。配合记录处理和订单状态跟踪两个实战练习,你能把知识点串成完整的应用场景。Schema Registry的使用也会一并讲到,保证数据格式的一致性。
八、Apache Flink流处理框架:
Kafka负责传输,Flink负责处理。课程最后带你进入流处理的世界。你会学到Flink的基础架构、如何消费Kafka数据、处理多条数据流、时间窗口和键控窗口的概念。课程还会深入讲解水位线机制用于处理乱序事件、有状态流处理、流之间的关联等高级主题。异常检测练习会让你用Flink构建一个真实可用的实时监控系统。
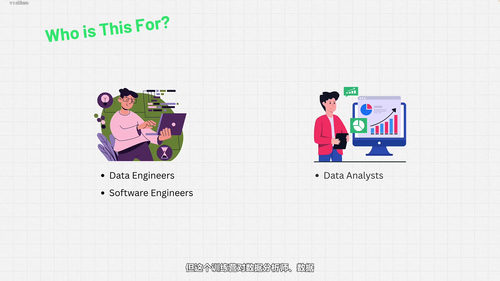
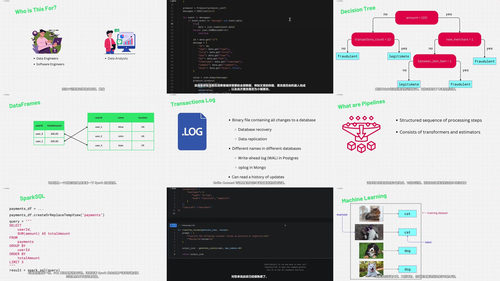
适合谁来学:数据分析出身的工程师想补齐工程短板,跟着课程走一遍会很有收获;软件开发背景的程序员想切入数据领域,也能从这里找到完整的技术路线图;在校学生或者刚毕业的新人想要系统入门数据工程,这套从零开始的路径规划比零散看技术博客要清晰得多。即使已经是数据分析师,只想搞清楚数据从产生到消费的完整链路,这门课同样能帮你建立起工程层面的认知。需要注意的是,课程涉及Python编程和基本SQL知识,完全没有编程基础的同学建议先补一补Python入门课。
学完这门训练营,你将能够独立设计并实现端到端的数据管道,覆盖批处理和实时处理两种场景;熟练使用Spark、Airflow、Kafka、Flink四大主流工具;理解如何在AWS上搭建数据湖和数据平台;并具备将机器学习和LLM融入数据工作流的能力。这些都是当前数据工程师岗位最核心的技能要求,也是从初学者成长为合格数据工程师的关键一步。