资源介绍
视频数量:17个
总时长:2小时30分
课程介绍:
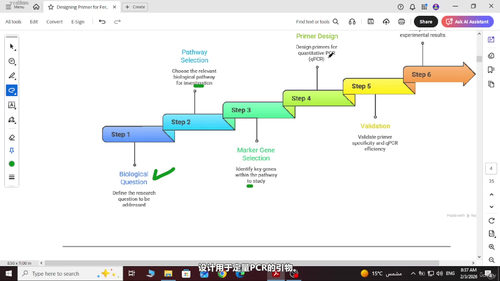
科研级基因表达引物设计实战教程
你有没有遇到过这样的时刻——实验方案已经写好,细胞模型也建好了,就差一对引物,结果翻遍试剂公司目录,根本找不到针对你研究物种的目标基因。商业化引物只覆盖最常见的模式生物,大鼠和灵长类动物的某些基因根本没有现成产品。怎么办?这门课就是从这种真实的困境出发的。
课程主讲人自己就经历过这样的死胡同。他在做铁死亡项目时,目标是研究铁依赖性的细胞死亡通路,团队设计好了生物学假设,却在引物这一步卡住了。买不到,就只能自己设计。于是他借助各种工具自学了生物信息学,事后回想起来,真正花时间的地方并不是操作本身有多复杂,而是没有人给他一条清晰的学习路径。多少研究人员在类似的死胡同里转了几周时间,而这件事其实几个小时就能搞定。这门课就是把那条清晰路径铺好,帮你省下那些浪费掉的时间。
课程面向的人群非常明确:分子生物学方向的硕士、博士候选人,以及在实验室里真正做实验的研究人员。你需要有一定的分子生物学基础,但不需要是生信专家。
整个课程分为几个层层递进的部分。
一、底层逻辑与失败原因
很多人一上来就想学怎么点鼠标、跑软件,但真正决定引物成败的是前期的实验设计逻辑。第一课会拆解一个真实的分子生物学实验到底是怎么设计出来的——从假设到变量控制,再到引物在其中扮演的角色。紧接着的半节课专门讲为什么引物在真实实验室里会失败,把常见踩坑的场景摊开来讲,让你提前知道哪些地方容易翻车。
二、研究目标的确定与靶基因选择
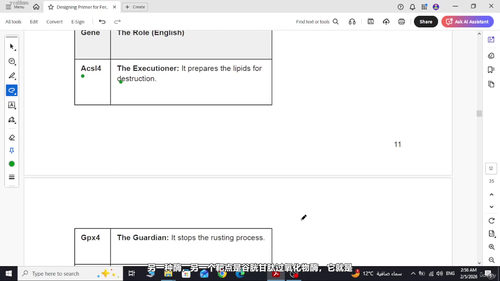
课程用铁死亡研究作为贯穿全篇的实际案例。你会跟着讲师的思路,理解铁死亡这个生物学过程的本质,认识其中的关键调控因子。讲师专门讲了为什么要选Hprt1作为内参基因,这个选择背后的逻辑往往被新手忽略。此外还提供了一个铁死亡相关的练习基因数据库,让你在学习过程中有具体可操作的靶标可以练手。
三、序列获取与转录本鉴别
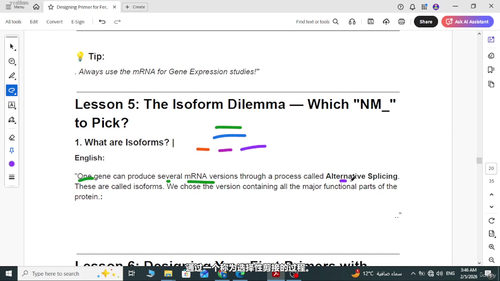
这是初学者最容易迷路的部分。第三课讲怎么在NCBI里找到目标基因的序列,但找到只是开始。真正的陷阱在于基因组DNA和mRNA的区别——很多新手不加区分直接设计引物,结果扩增出来的根本不是预期片段。第五课专门处理异构体困境:一个基因往往对应多种转录本变体,编号NM_后面那一串数字究竟该选哪一个?课程会带你理解选择性剪接的生物学背景,教会你在多个异构体之间做出有依据的选择。
四、引物设计与质量评估
第六课进入实操环节,使用Primer-BLAST工具设计第一对引物。讲师会一步步演示从输入序列到设置参数(比如PCR产物大小、长度范围)的完整流程。设计出来不等于能用,第七课专门讲怎么评估引物质量,讲师还会演示如何保存BLAST报告,并借助AI工具辅助评估引物的特异性。第八课用IDT的OligoAnalyzer工具检查引物的二级结构和发夹结构等隐患。
五、策略性修改与故障排查
评估结果不理想时,不是简单推倒重来,而是要学会策略性修改。第九课讲的是怎么跳过那些麻烦区域——比如高GC含量区段、重复序列区域、容易形成二聚体的位点。课程还配套了PCR失败排查决策树,把常见失败模式对应到具体解决方案。
六、面向审稿人的实验设计
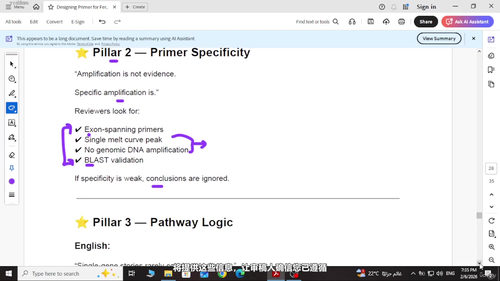
最后两课把视角拉高到论文发表层面。第十课解析审稿人在审稿时究竟怎么看你的基因表达研究,他们重点检查哪些环节、引物设计中的哪些问题会成为直接拒稿的理由。第十一课教你如何把这些设计细节写进qPCR方法学部分,写出一份经得起审稿人推敲的方法学描述。
学完这门课,你不仅能独立完成从靶基因选择到引物验证的完整流程,更重要的是建立起一套实验设计层面的思维方式:每一个引物决策背后都有生物学逻辑,每一次修改都有据可依,不再是凭感觉试错。无论你是在做铁死亡、肿瘤、神经退行性疾病,还是其他任何涉及基因表达的课题,这套方法论都是通用的。