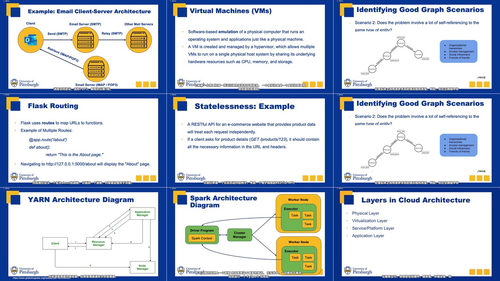
资源介绍
视频数量:72个
总时长:8小时52分
课程介绍:
数据科学云计算专项进阶教程
想象一个场景:公司丢过来几个TB的用户行为日志,老板下周要看用户留存分析,单台服务器根本跑不动,传统数据库也撑不住。这时候你需要的,是弄明白该用哪套技术栈解决问题。这门课程就是为这类实际诉求设计的,从底层的大数据处理框架,到云端架构搭建,再到后端服务开发,把整套数据工程的技术链条串起来。
课程分三大板块,从内向外、从底层到上层逐步推进。
一、Hadoop与Spark大数据处理
先从Hadoop架构入手,搞清楚HDFS如何把大文件切成数据块分散存储到成百上千台机器上,YARN怎么协调集群资源和任务调度。还会梳理Hive、HBase、Sqoop等生态组件各自解决什么问题。
并行编程模型这一节,先讲MapReduce的核心思想,把任务拆成Map和Reduce两个阶段,理解数据是怎么在集群里流动和shuffle的。配套实战用Python写MapReduce做单词统计和日志分析,再练Apache Pig脚本,感受高级抽象语言如何大幅简化MapReduce开发。
Spark部分深入到核心概念和架构,讲清楚RDD、DataFrame的运行机制,以及Spark相比MapReduce快在哪里。最后落到PySpark编程和Spark MLlib机器学习库,通过与scikit-learn的对比案例,理解分布式环境下做机器学习建模的特殊性。
二、云计算基础与云端数据基础设施
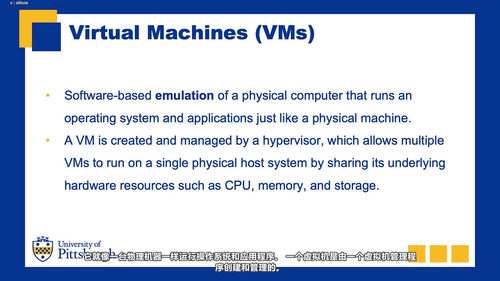
从云计算的历史讲起,理解它从主机租赁演变成今天公有云、私有云、混合云的过程。核心内容是使能技术和三大服务模型:虚拟化、网络、存储这些底层支撑如何运作,IaaS、PaaS、SaaS分别面向什么用户。配套实战会带你用VirtualBox搭Ubuntu虚拟机,用Git和GitHub管理代码。
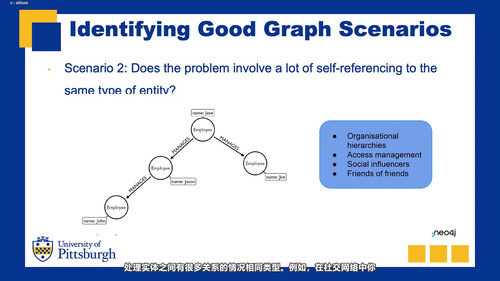
云端数据基础设施先复习关系型数据库的范式设计和SQL语法,再对比数据库、数据仓库、数据湖三种存储形态,讲清星型模型和雪花模型在OLAP场景下的设计取舍。Airbnb、Netflix、Spotify、Expedia等公司的真实建模案例穿插其中。NoSQL部分讲清楚与关系型数据库的区别,深入MongoDB的增删改查、聚合管道、水平扩容操作,再带入门Neo4j图数据库和Cypher查询语言。
三、分布式系统架构与Web服务
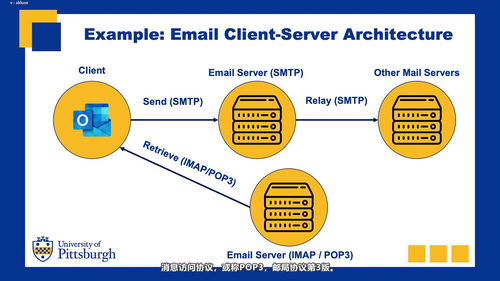
这板块偏后端工程。先拆解分布式系统与集中式系统的区别,再逐一讲解客户端-服务器、对等网络、分层架构、微服务几种主流架构风格。Instagram、BitTorrent、Netflix、Uber等公司的真实案例穿插进来,理解大型系统是怎么组织起来的。
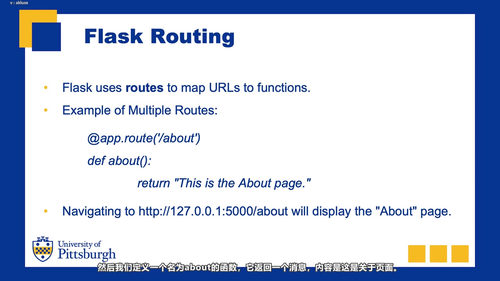
Web服务从HTTP协议入手,讲清请求方法、状态码等基础概念,然后进入RESTful设计原则。Twitter、OpenWeatherMap、纽约时报的公开API都被拿来做案例。Flask框架从零搭建,涵盖路由、模板、静态文件、HTTP方法处理,最后用银行系统和书店系统两个完整项目带你把RESTful API真正写出来。
虚拟化部分讲Docker容器技术,对比它和传统虚拟机的差异,实战环节会带你把Flask API打包成Docker镜像。云存储部分讲清块存储、对象存储、分布式文件系统的特点和适用场景,通过Google Cloud Storage的API实战,让你动手操作真实的云存储服务。
学完这套课程,你对数据科学领域用到的云计算和大数据技术会形成一个完整的认知图谱。碰到海量数据时知道该选Hadoop还是Spark,碰到实时要求时知道怎么用PySpark和MLlib建模,碰到业务规模扩大时知道怎么选数据库、怎么拆微服务、怎么上云。这些都是面试和实际项目里能直接派上用场的本事。